La inteligencia artificial ha cambiado la forma en que se hace ciencia al permitir que los investigadores analicen las cantidades masivas de datos que generan los instrumentos científicos modernos. Puede encontrar una aguja en un millón de pajares de información y, usando aprendizaje profundo, puede aprender de los propios datos. La IA está acelerando los avances en caza de genes, medicamento, diseño de drogas y la creación de compuestos orgánicos.
El aprendizaje profundo utiliza algoritmos, a menudo redes neuronales que se entrenan en grandes cantidades de datos, para extraer información de nuevos datos. Es muy diferente de la informática tradicional con sus instrucciones paso a paso. Más bien, aprende de los datos. El aprendizaje profundo es mucho menos transparente que la programación informática tradicional, lo que deja preguntas importantes: ¿qué ha aprendido el sistema, qué sabe?
Como un profesor de química Me gusta diseñar pruebas que tengan al menos una pregunta difícil que amplíe el conocimiento de los estudiantes para establecer si pueden combinar diferentes ideas y sintetizar nuevas ideas y conceptos. Hemos ideado una pregunta de este tipo para el ejemplo de los defensores de la IA, AlphaFold, que ha resuelto el problema de plegamiento de proteínas.
plegamiento de proteínas


Saludos humanoides
Suscríbase a nuestro boletín ahora para recibir un resumen semanal de nuestras historias favoritas de IA en su bandeja de entrada.
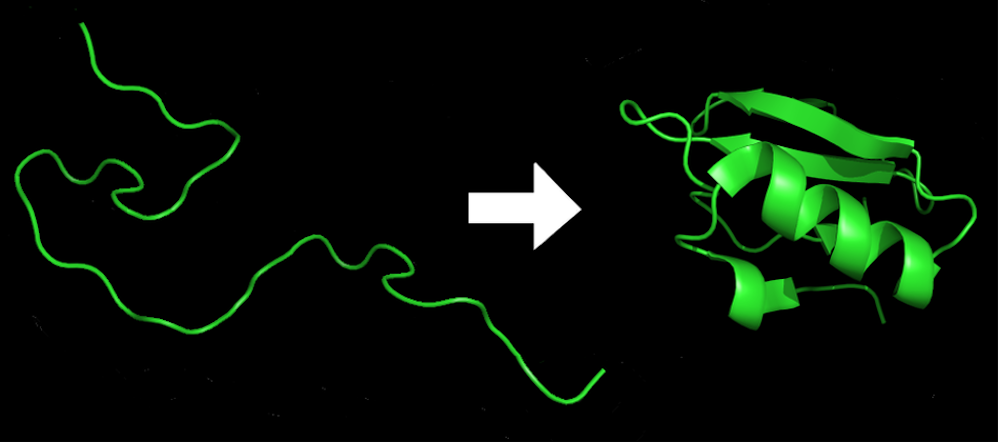
Las proteínas están presentes en todos los organismos vivos. Proporcionan estructura a las células, catalizan reacciones, transportan pequeñas moléculas, digieren alimentos y hacen mucho más. Están formados por largas cadenas de aminoácidos como cuentas en un hilo. Pero para que una proteína haga su trabajo en la célula, debe retorcerse y doblarse en una estructura tridimensional compleja, un proceso llamado plegamiento de proteínas. Las proteínas mal plegadas pueden provocar enfermedades.
En su discurso de aceptación del Nobel de química en 1972, cristian anfinsen postuló que debería ser posible calcular la estructura tridimensional de una proteína a partir de la secuencia de sus componentes básicoslos aminoácidos.
Así como el orden y el espaciado de las letras en este artículo le dan sentido y mensaje, el orden de los aminoácidos determina la identidad y la forma de la proteína, lo que resulta en su función.
marc zimmer, CC BY-ND
Debido a la flexibilidad inherente de los componentes básicos de los aminoácidos, una proteína típica puede adoptar una 10 elevado a 300 formas diferentes. Este es un número enorme, más que el número de átomos en el universo. Sin embargo, en un milisegundo, cada proteína en un organismo se doblará en su propia forma específica: la disposición de energía más baja de todos los enlaces químicos que componen la proteína. Cambie solo un aminoácido de los cientos de aminoácidos que normalmente se encuentran en una proteína y puede que se pliegue incorrectamente y ya no funcione.
AlphaFold
Durante 50 años, los científicos informáticos han tratado de resolver el problema del plegamiento de proteínas, con poco éxito. Luego en 2016 Mente profundauna subsidiaria de IA de la matriz de Google, Alphabet, inició su AlphaFold programa. Usó el banco de datos de proteínas como su conjunto de entrenamiento, que contiene las estructuras determinadas experimentalmente de más de 150.000 proteínas.
En menos de cinco años, AlphaFold había venció el problema del plegamiento de proteínas – al menos la parte más útil, es decir, determinar la estructura de la proteína a partir de su secuencia de aminoácidos. AlphaFold no explica cómo se pliegan las proteínas con tanta rapidez y precisión. Fue una gran victoria para la IA, porque no solo acumuló un gran prestigio científico, sino que también fue un gran avance científico que podría afectar la vida de todos.
Hoy, gracias a programas como AlphaFold2 y RosaTTADoblar, los investigadores como yo pueden determinar la estructura tridimensional de las proteínas a partir de la secuencia de aminoácidos que componen la proteína, sin costo alguno, en una o dos horas. Antes de AlphaFold2 teníamos que cristalizar las proteínas y resolver las estructuras usando Cristalografía de rayos Xun proceso que tomó meses y costó decenas de miles de dólares por estructura.
Ahora también tenemos acceso a la Base de datos de estructura de proteínas AlphaFold, donde Deepmind ha depositado las estructuras 3D de casi todas las proteínas que se encuentran en humanos, ratones y más de otras 20 especies. Hasta la fecha, ha resuelto más de un millón de estructuras y planea agregar otras 100 millones de estructuras solo este año. El conocimiento de las proteínas se ha disparado. Es probable que la estructura de la mitad de todas las proteínas conocidas esté documentada para fines de 2022, entre ellas muchas nuevas estructuras únicas asociadas con nuevas funciones útiles.
Pensando como un químico
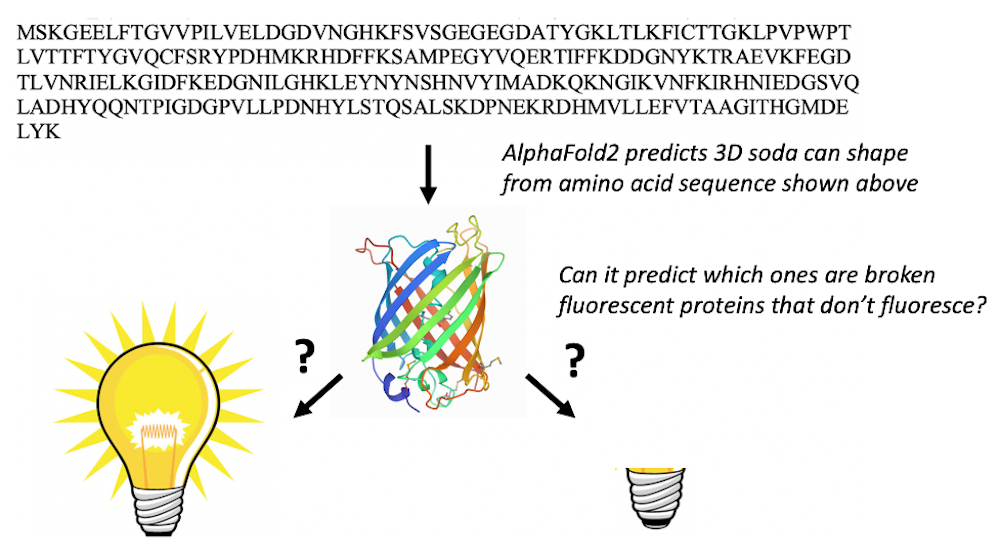
AlphaFold2 no fue diseñado para predecir cómo las proteínas interactuarían entre sí, sin embargo, ha sido capaz de modelar cómo las proteínas individuales se combinan para forman grandes unidades complejas compuestas de múltiples proteínas. Teníamos una pregunta desafiante para AlphaFold: ¿su conjunto de entrenamiento estructural le había enseñado algo de química? ¿Podría decir si los aminoácidos reaccionarían entre sí, un hecho raro pero importante?
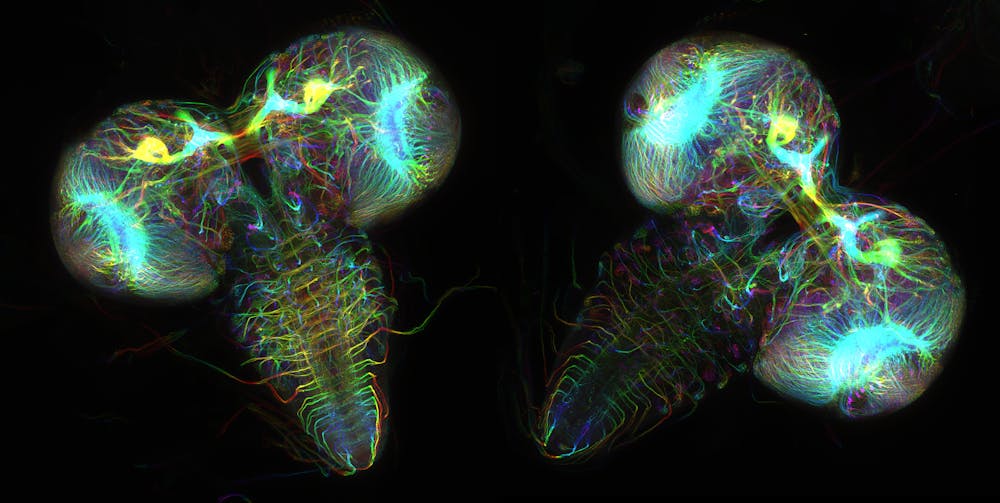
Soy un químico computacional interesado en proteínas fluorescentes. Estas son proteínas que se encuentran en cientos de organismos marinos como medusas y corales. Su brillo se puede utilizar iluminar y estudiar enfermedades.
Wen Lu y Vladimir I. Gelfand, Facultad de Medicina Feinberg, Universidad Northwestern
Hay 578 proteínas fluorescentes en el banco de datos de proteínas, de los cuales 10 están «rotos» y no emiten fluorescencia. Las proteínas rara vez se atacan a sí mismas, un proceso llamado modificación postraduccional autocatalítica, y es muy difícil predecir qué proteínas reaccionarán consigo mismas y cuáles no.
Solo un químico con una cantidad significativa de conocimientos sobre proteínas fluorescentes podría usar la secuencia de aminoácidos para encontrar las proteínas fluorescentes que tienen la secuencia de aminoácidos adecuada para sufrir las transformaciones químicas necesarias para hacerlas fluorescentes. Cuando le presentamos a AlphaFold2 las secuencias de 44 proteínas fluorescentes que no están en el banco de datos de proteínas, plegó las proteínas fluorescentes fijas de manera diferente a las rotas.
marc zimmer, CC BY-ND
El resultado nos sorprendió: AlphaFold2 había aprendido algo de química. Había descubierto qué aminoácidos en las proteínas fluorescentes hacen la química que las hace brillar. Sospechamos que el conjunto de entrenamiento del banco de datos de proteínas y múltiples alineaciones de secuencias permitir que AlphaFold2 «piense» como los químicos y busque los aminoácidos necesarios para reaccionar entre sí para hacer que la proteína sea fluorescente.
Un programa de plegado que aprende algo de química de su conjunto de entrenamiento también tiene implicaciones más amplias. Al hacer las preguntas correctas, ¿qué más se puede obtener de otros algoritmos de aprendizaje profundo? ¿Podrían los algoritmos de reconocimiento facial encontrar marcadores ocultos de enfermedades? ¿Podrían los algoritmos diseñados para predecir los patrones de gasto entre los consumidores también encontrar una propensión a pequeños robos o engaños? Y lo más importante, ¿es esta capacidad, y saltos similares en la capacidad en otros sistemas de IA, ¿deseable?
Este artículo de marc zimmerProfesor de Química, Universidad de Connecticutse vuelve a publicar de La conversación bajo una licencia Creative Commons. Leer el artículo original.
También Te Puede Interesar:

Meta finalizará las actualizaciones del sistema operativo Quest 2 en 2027
Las alertas de software espía de Apple llegan a parlamentarios y periodistas alemanes en 99 países

El Apple Watch Ultra 4 tiene un descuento de $100, igualando su mejor precio hasta la fecha
Meta estaría considerando vender bonos por 20.000 millones de dólares, la primera en euros

Squarespace está despidiendo al 19 por ciento de los empleados
Musk dice que Colossus 2 se está expandiendo a sitios llamados Spam y Gun Range

Cada vez más supermercados europeos sufren ataques contra sus congeladores
Hello Group compra una participación mayoritaria en la aplicación de citas holandesa Inner Circle
Deutsche Bank supuestamente mejora la tecnología estadounidense después de la venta masiva de 2 bill...

Primer vistazo al HomePod Mini 2: tres cosas que me encantan y una decepción
ADNOC firma un acuerdo con OpenAI y G42 para desplegar agentes de Frontier AI
