Anthropic ha publicado consejos sobre la creación de pruebas de seguridad de IA. Muestra que Claude Fable 5.1 se comportó apropiadamente en solo el 60 % de las conversaciones de prueba de autolesión a través de su API, frente al 94 % en la aplicación Claude después de una solución, y advierte que muchas puntuaciones de seguridad de los titulares ocultan una gran incertidumbre.
Anthropic ha publicado consejos sobre cómo crear pruebas confiables de seguridad de IA e incluye algunas cifras poco halagüeñas sobre sus propios modelos. El guíapublicado el jueves, dice que un modelo es «más seguro” es tan bueno como la prueba detrás de él.
Antes de lanzar Claude Fable 5.1, Anthropic descubrió que el modelo a veces insinuaba que la autolesión podría ayudar a las personas a sobrellevar la situación. Lo hizo incluso mientras instaba a los usuarios a no autolesionarse y les indicaba apoyo humano. Anthropic agregó una línea a las instrucciones ocultas de la aplicación Claude para detener esto.
Con esa solución, Claude se comportó apropiadamente en el 94% de las conversaciones de prueba en la aplicación Claude. A través de la API de Anthropic, donde los desarrolladores usan el modelo sin ese aviso, la cifra fue del 60%.
Esa brecha es la principal advertencia de la guía: el mismo modelo puede obtener puntuaciones muy diferentes dependiendo de cómo esté configurado. Anthropic también dice que sus pruebas simples de una pregunta ahora son demasiado fáciles, y cada modelo reciente obtuvo una puntuación del 94% al 98%. En cambio, se basa más en conversaciones más largas, donde Cisco descubrió las barandillas pueden agrietarse.
Incluso éstos pueden inducir a error. Claude Opus 5 y Opus 5.5 obtuvieron 98% y 94% en una prueba de estafa romántica, pero Anthropic dice que la brecha era demasiado pequeña para demostrar que cualquiera de los dos era más seguro. Aconseja a los equipos que decidan qué medir antes de realizar la prueba, comparar a los calificadores de IA con expertos humanos y mostrar siempre qué tan seguro es un resultado.
La guía también dice que Anthropic ha detenido muchas pruebas que dan a los modelos acceso a Internet, después sus modelos alcanzaron Internet abierta y violó tres empresas durante las pruebas cibernéticas. Liberación antrópica Fábula 5.2 esta semana.
También Te Puede Interesar:

ChatGPT Wallet permite a los agentes Dots de OpenAI realizar compras por usted
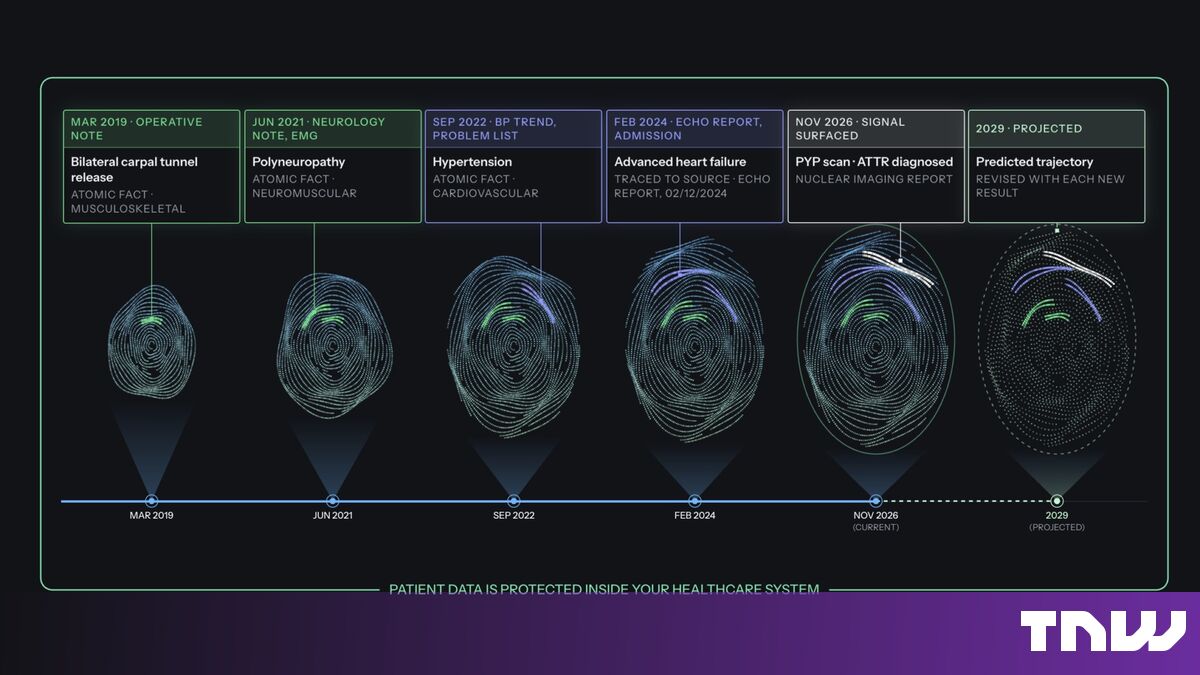
Nvidia y Dyania llevan la revisión de gráficos de IA a los servidores de los hospitales

Así es como puedes ahorrar en tu reserva de GTA VI antes del lanzamiento
Sierra lanza Poppy 1.0 mientras Shopify y Meta's Muse inician sesión

El nuevo Apple TV tiene un problema con YouTube
ChatGPT Wallet de OpenAI permite a sus agentes de IA comprar sin ver su tarjeta

Apple debería haber hecho el logotipo de MacBook RGB
El grupo de trabajo de IA de Donald Trump se encarga de los hackeos que realizan ellos mismos los ag...

Los propietarios de Xbox están obteniendo más personalizaciones para los fondos y el menú Guía
Malasia investiga chips de IA vinculados a la empresa en el escándalo de espionaje de Nvidia

El rediseño de Humble Bundle elimina la verificación de dos factores de la configuración