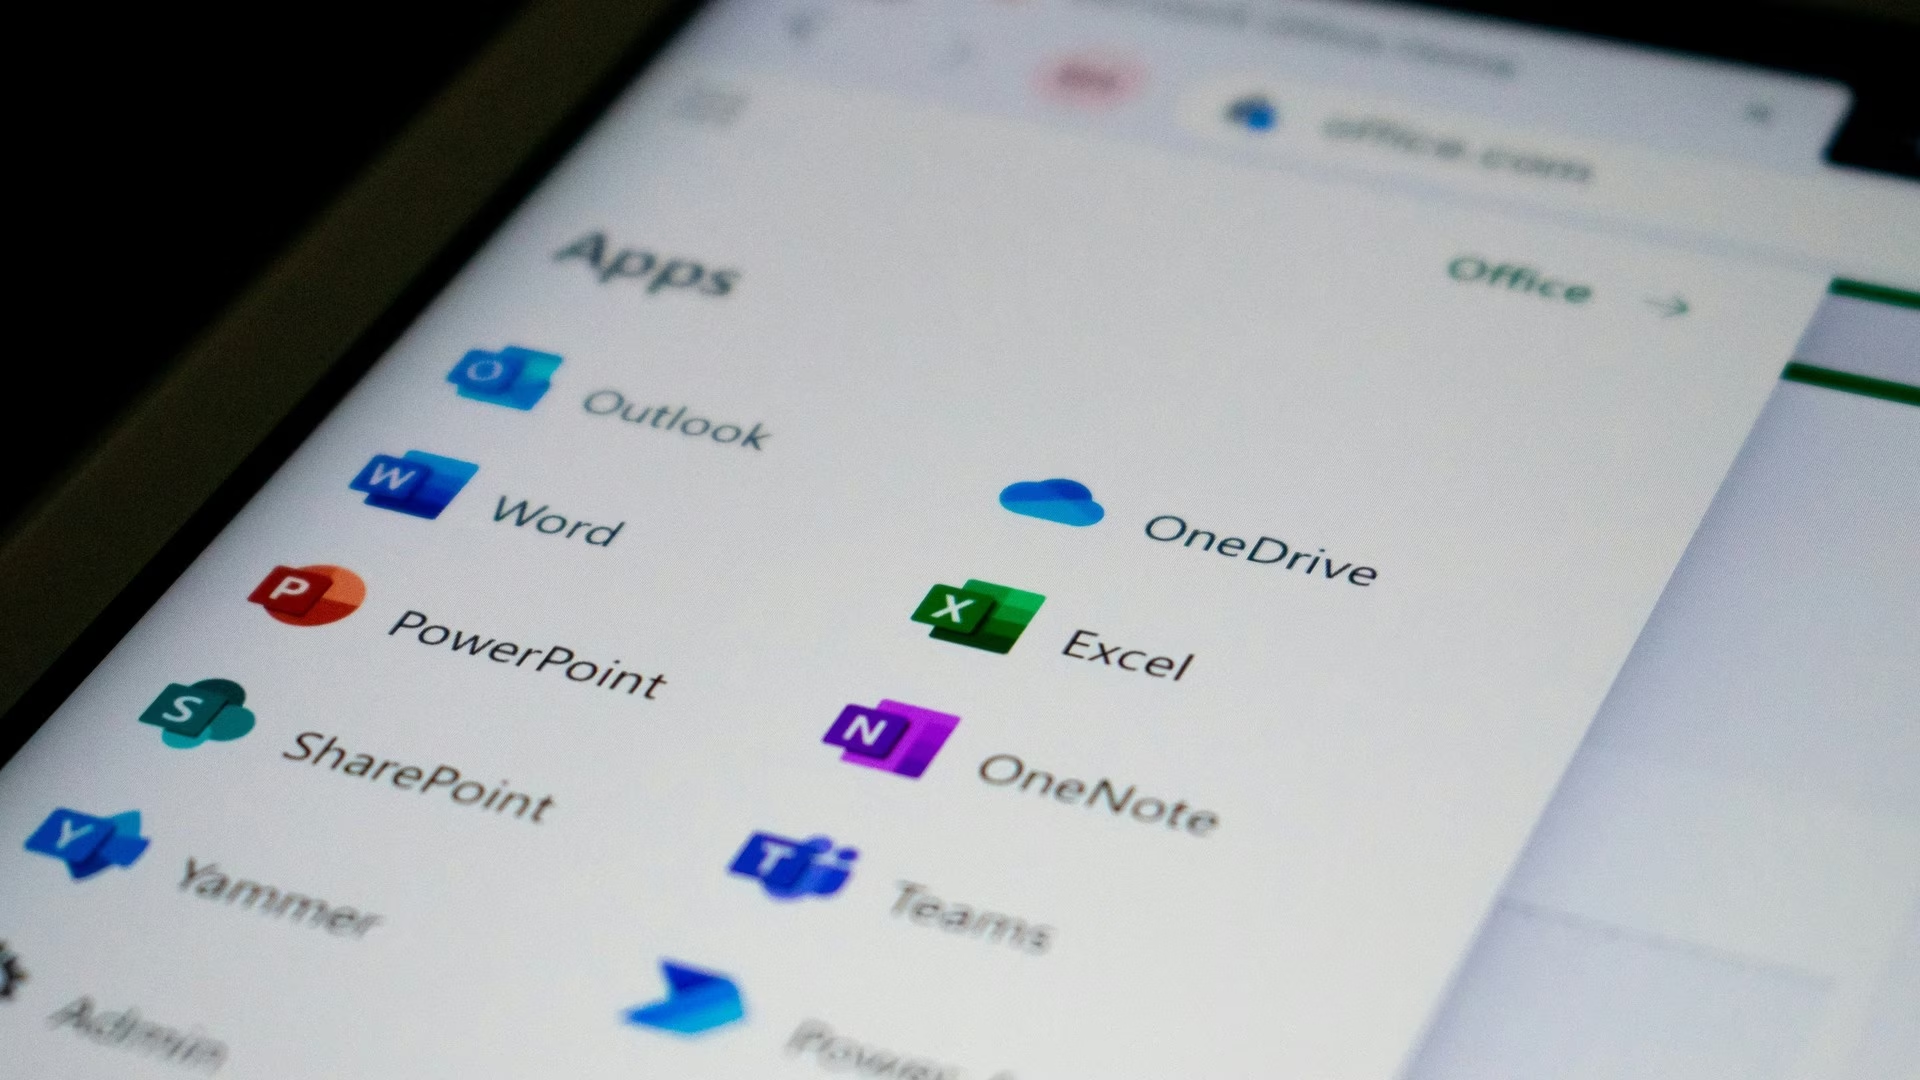
Microsoft ha rastreado la interrupción global de Microsoft 365 de la semana pasada hasta una actualización de julio para sus servidores de puerta de enlace de red. El error permaneció inactivo durante más de tres meses antes de que un aumento en la carga y una caída en la capacidad lo activaran, según el informe preliminar posterior al incidente de la compañía.
Microsoft publicó el informe a los clientes en el centro de administración de Microsoft 365 el 15 de noviembre. El Registro informó. Charles Lamanna, vicepresidente ejecutivo de Copilot, agentes y plataforma de Microsoft, publicó una versión abreviada en X el lunes, ZDNET informó.
«Un defecto latente provocó que los servidores se saturaran y dejaran de responder bajo ciertas condiciones de carga», escribió Lamanna.
Tres cosas a la vez
La actualización de julio se creó específicamente para los servidores de puerta de enlace de red de Microsoft 365. Pasó las pruebas de carga y funcionó en todo el mundo sin problemas, dijo Microsoft. Pero el defecto provocó una contención de bloqueos dentro de un proceso interno de Windows, que agotó la CPU y la memoria del servidor.
Las pruebas no lo lograron porque las pruebas de carga se centraron en hardware más débil con menos núcleos, según el informe. La disputa es peor en las máquinas más nuevas con más núcleos.
Luego se cumplieron otras dos condiciones. Los equipos conmutaron por error a la puerta de enlace que también transporta Exchange Online, lo que aumentó la carga. Al mismo tiempo, un problema no relacionado del día anterior había dejado fuera de servicio casi el 14% de la capacidad del servidor de la puerta de enlace.
Cuando un servidor dejó de responder, el tráfico pasó al siguiente en buen estado, que luego sufrió el mismo error. En dos horas, más del 80% de los servidores no respondían en el punto más bajo, según el informe.
¿Por qué la recuperación tardó tanto?
El tráfico en espera volvió a saturar los servidores tan pronto como volvieron a estar en línea. Microsoft dijo que su recuperación automatizada no fue diseñada para una falla tan amplia.
«Dado que el defecto principal del código era un error latente de varios meses antes, nuestras opciones normales de reversión, vuelo y características no pudieron revertir rápidamente el cambio», escribió Lamanna.
En cambio, los ingenieros escribieron una actualización que devolvió la ruta del código de Windows a su estado anterior. Lo aplicaron a grupos de servidores por turno. Teams, OneDrive, SharePoint y las aplicaciones de Office pudieron salir de las puertas de enlace defectuosas y regresar antes. Exchange Online no pudo, por razones de escala, razón por la cual Outlook estuvo inactivo por más tiempo.
El cronograma del informe, publicado por The Register, comienza con la conmutación por error de Teams a la 01:07 UTC del 12 de noviembre. El primer caso de soporte llegó a las 16:33 UTC. Microsoft aplicó su solución a las 07:20 UTC del 13 de noviembre y envió su actualización final al cliente a las 04:15 UTC del 14 de noviembre.
Más de 1.000 ingenieros y otro personal se unieron a las llamadas sobre interrupciones lideradas por Lamanna y el jefe de la nube Scott Guthrie. Bloomberg informó. El 13 de noviembre, Microsoft se disculpó y dijo que la causa no fue un ciberataque ni agentes de inteligencia artificial.
Lamentamos profundamente la interrupción que este incidente ha causado a nuestros clientes y socios. Conocemos la confianza que depositan en nuestros servicios y nos tomamos esa responsabilidad muy en serio. Estamos viendo una amplia recuperación y estabilidad en todos nuestros servicios.
Este fue un problema técnico no relacionado con la cibernética o la IA/agentes. El incidente se produjo por un problema durante una actualización anterior de la capacidad de la red que surgió luego de un cambio reciente en la red. Hemos abordado el problema subyacente y continuamos restableciendo el servicio a los clientes y regiones restantes.
Dada la magnitud de la demanda, restablecimos los servicios gradualmente, validando la estabilidad en cada etapa. Si bien esto llevó más tiempo, ayudó a garantizar una restauración estable.
Proporcionaremos un informe completo posterior al incidente una vez que se complete nuestra revisión.
-Microsoft (@Microsoft) 13 de noviembre de 2026
Preguntas en Washington
La interrupción afectó a gobiernos, tribunales, hospitales y empresas. Downdetector registró informes de 74 países y territorios, según el Prensa asociada. TNW cubierto el restablecimiento de los servicios y El debate sobre la soberanía de Europa que siguió.
Mes pasado, una interrupción de Google Cloud en su región de Londres afectó a servicios como Revolut.
dijo el presidente del Comité de Seguridad Nacional de la Cámara de Representantes, Andrew Garbarino politico Estaba buscando más información de Microsoft y CISA.
«Necesitamos entender qué sucedió y cómo hacer que estos sistemas sean más resilientes», dijo Garbarino.
Microsoft planea publicar su informe final posterior al incidente el 20 de noviembre, según The Register.
También Te Puede Interesar:

California demanda a OpenAI por incidentes de piratería de IA no autorizados
Los jefes tecnológicos de China y Elon Musk se dirigen a Shenzhen para la cumbre de directores ejecu...

El fiscal general del estado de California demanda a OpenAI por incidentes con agentes deshonestos

Apple está probando límites de uso diario para interacciones más complejas con Siri AI
AdMob de Google permite a agentes de inteligencia artificial como Claude Code configurar anuncios de...
Tu casa puede ayudar a ahorrar: así es el hogar inteligente que hace tu día a día más fácil – Samsun...

El FBI dice que la herramienta de piratería de código abierto Artex AI se utilizó para violar redes ...

Los accesorios de PlayStation 5 de Sony son más baratos antes del Black Friday
China quiere que todos sus alumnos alfabeticen en IA para 2030, según una investigación de Reuters

Mazama Energy tiene una solución para el mayor problema de perforación geotérmica

El escándalo de Nvidia no disminuye