A través de la capa de infraestructura que impulsa Aplicaciones de IAMarkdown se ha convertido en un nuevo estándar. Cada vez más proveedores lo utilizan como salida predeterminada para cualquier cosa que un modelo necesite leer, y van más allá de la notación de objetos JavaScript (JSON) como el formato de referencia único para todos.
Este cambio real y continuo refleja cómo se entrenan los grandes modelos de lenguaje, cómo las interfaces de chat generan respuestas y cómo los desarrolladores construyen realmente con tokens. ventanas de contextoy el costo en mente. Y hay buenas razones para esta adopción.
Markdown se adapta a cómo funcionan los modelos
Se han entrenado grandes modelos de lenguaje con enormes cantidades de Markdown. Piense en sitios de documentación, archivos README, blogs técnicos, hilos de foros, bases de conocimientos, etc. Esa exposición significa que los modelos ya hablan Markdown con fluidez; saben cómo analizar sus encabezados, listas, tablas y límites de código, y tratarlos como señales semánticas en lugar de ruido.
Al mismo tiempo, las interfaces de chat orientadas al usuario ya pueden generar respuestas de Markdown. Cuando un modelo genera Markdown, la interfaz puede mostrarlo limpiamente sin transformaciones adicionales. Cuando el mismo modelo ingiere Markdown, recibe información en una forma que refleja su distribución de entrenamiento y la forma en que se espera que responda. El resultado es un bucle de entrada-salida más natural que alimentar modelos JSON densos y anidados que deben descomprimirse mentalmente antes de su uso.
Si miras las cosas desde una perspectiva simbólica, Markdown también es el enfoque más sencillo. Elimina los gastos generales estructurales y mantiene la carga útil de información. Para Agentes de IA que debe encajar grandes cantidades de contexto en una ventana limitada, esa eficiencia se traduce directamente en contenido más relevante por solicitud y menor costo por inferencia.
Una tendencia visible
El paso a Markdown tampoco es especulativo. Ya está codificado en la guía de mejores prácticas de los principales proveedores de modelos. OpenAI ingeniería rápida La documentación recomienda explícitamente estructurar los mensajes de los desarrolladores con encabezados Markdown, listas de viñetas y tablas cuando sea útil. La guía recomienda el uso de ‘##’ para las secciones principales, comillas invertidas en línea para el código y un formato jerárquico claro para mejorar el cumplimiento y la legibilidad del modelo.
Las guías de indicaciones de terceros se hacen eco de este mismo patrón. Utilizan encabezados de Markdown para crear saltos de sección, listas para enumeraciones y tablas para comparaciones. Varios análisis señalan que Markdown es más eficiente con los tokens y los modelos entrenados en documentación lo entienden de manera más natural, lo que lo convierte en una herramienta de formato preferida para solicitudes complejas, especialmente con los modelos más nuevos de la serie GPT-5.
Los proveedores de infraestructura están de acuerdo
Markdown también se ha ganado el favor de los proveedores de datos y API. Donde alguna vez JSON gobernó como el formato de intercambio universal, muchos ahora ofrecen variantes de Markdown optimizadas para el consumo de LLM. El razonamiento es exactamente el mismo: quieren reducir hinchazón simbólicasimplifique el análisis para los agentes y alinee la forma en que se solicitan los modelos y cómo se muestran las respuestas.
SerpApiuna empresa de API de datos de búsqueda fundada hace nueve años, recientemente lanzó la salida Markdown en sus más de 100 API sin costo adicional. SerpApi ofrece a desarrolladores, investigadores y empresas de Fortune 500 información estructurada de Google, Bing, YouTube y otras fuentes. La función permite a los desarrolladores solicitar resultados de búsqueda de forma simbólica Reducción formato en lugar de JSON, dirigido específicamente a agentes de IA y aplicaciones impulsadas por LLM. No se requiere un nuevo punto final y el formato se solicita a través de un parámetro de consulta, extensión de ruta o encabezado en integraciones existentes.
En un ejemplo del mundo real de los propios puntos de referencia de SerpApi, una sola búsqueda en Google de «café» cuesta 24.723 tokens como JSON y 6.435 tokens como Markdown, lo que suma una reducción del 74%. Cuando se combinó con el filtrado de campos, la misma respuesta se redujo aún más a 1298 tokens. En todas sus API, SerpApi informa un ahorro promedio de tokens de aproximadamente el 50 %, y algunos puntos finales experimentan reducciones de hasta el 90 %.
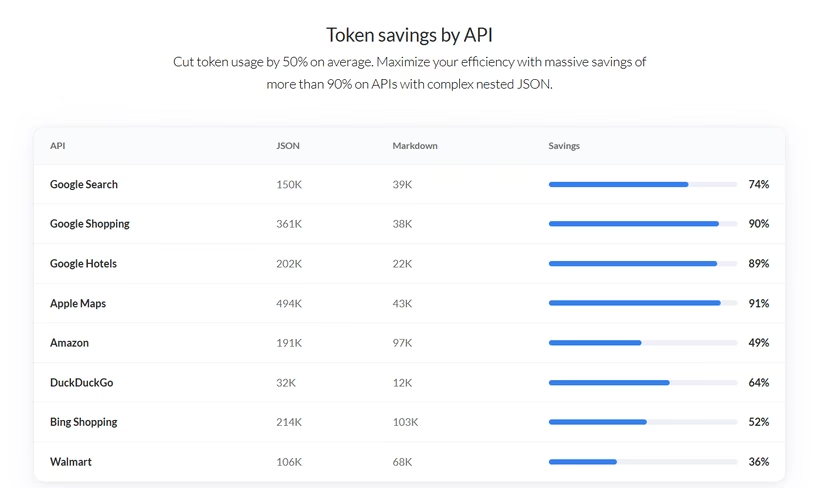
Estos números son importantes porque los resultados de búsqueda se encuentran entre las cargas útiles más ruidosas y anidadas que ingieren los agentes. Las respuestas JSON contienen enlaces de redireccionamiento, favicons, parámetros de seguimiento y metadatos profundamente anidados sobre los que los modelos no necesitan razonar. La salida de Markdown, por el contrario, conserva la información principal, como títulos, fragmentos, enlaces, precios y calificaciones en tablas y listas, al tiempo que elimina automáticamente gran parte del ruido de seguimiento interno y los campos duplicados.
Los desarrolladores pueden acceder al nuevo formato Markdown agregando ‘output=md’ a la cadena de consulta, llamando a la ruta ‘/search.md’ o configurando un encabezado ‘Aceptar: texto/markdown’. Las respuestas incluyen contenido YAML para metadatos, tablas Markdown estructuradas para conjuntos de resultados y enlaces nativos en línea, todos diseñados para colocarse directamente en las indicaciones o en la memoria del agente.
¿Qué significa todo esto?
A medida que agentes en lugar de humanos consumen más parte de la web, la capa de infraestructura se optimizará cada vez más para la legibilidad de las máquinas en lugar de un anidamiento amigable para los humanos. JSON sigue siendo esencial para la manipulación programática y la aplicación estricta de esquemas, pero para la fase de ingesta de contexto de los flujos de trabajo de IA, Markdown se está convirtiendo en el nuevo valor predeterminado.
Por lo tanto, en los próximos meses, uno debería esperar que más proveedores de datos ofrezcan variantes de Markdown de sus respuestas, especialmente para búsqueda, comercio electrónico, mapas y API de contenido donde la eficiencia de los tokens tiene un impacto inmediato en el costo y el rendimiento. También es probable que las plantillas de avisos y los marcos de agentes se estandaricen en las secciones, tablas y listas de Markdown como la forma canónica de presentar el contexto recuperado a los modelos. Las herramientas también deberían evolucionar en torno a la medición y minimización de la huella del token, con Markdown como palanca principal.
Para los desarrolladores que construyen con LLM hoy en día, la escritura está en la pared. Al introducir datos externos en los modelos, se deben preferir formatos que coincidan con la forma en que se entrenan los modelos y cómo se generan. Markdown ya no es sólo una herramienta de documentación. Se está convirtiendo en la nueva lengua franca entre los datos de búsqueda y los modelos de IA.